Als nächsten Schritt in der Weiterentwicklung des Kieselstein ERP wird die Implementierung des aktuellen Wildfly (Applikationsserver) und damit verbunden die Verwendung der aktuellen Jackrabbit Version Oak (die Eiche) umgesetzt. Damit konnte auch auf Java 25 gewechselt werden.
Damit ist verbunden, dass die Dokumentendatenbank migriert werden muss. Das bedeutet, dass diese Umstellung sehr gut geprüft werden muss, da es, von Seiten der Dokumentendatenbank keine Möglichkeit gibt, wieder mit den alten Daten / Dokumenten weiterzuarbeiten.
Anmerkung:
Natürlich kann man die neu erzeugten Dokumente verwerfen und auf die alte Dokumentendatenbank zurückschalten und die wenigen neu erzeugten Dokumente erneut einspielen / erzeugen.
Wenn man aber erst nach einiger Zeit feststellt, dass es ein nicht erwünschtes Verhalten geben sollte, das in den Tests nicht aufgefallen ist, muss dieser Fehler korrigiert werden. Wie schnell das umgesetzt werden kann, hängt von der zeitlichen Situation ab.
Unsere Empfehlung
Wenn du von der Version 1.x kommst, so solltest du bitte vorher die Version 2.0.x zumindest einige Wochen im Echtbetrieb im Einsatz haben.Der technische Hintergrund ist, dass von der V2.0.x quasi jederzeit ein Downgrade auf die 1.1.17 gemacht werden kann. Ab der Verwendung der 2.1.x ist dies nicht mehr möglich.
Weiters sind damit folgende Aktualisierungen der verwendeten Pakete verbunden:
- Update auf Java 25
- Update auf Wildfly 41
- Update auf Hibernate 7
- Queries an Hibernate 7 angepasst
- Umstellung der Packages von javax -> jakarta
- Jackrabbit durch Apache Oak ersetzen
- Hibernate ID Generatoren verwenden. Damit wird der PK-Generator hinfällig.
Installation Java 25
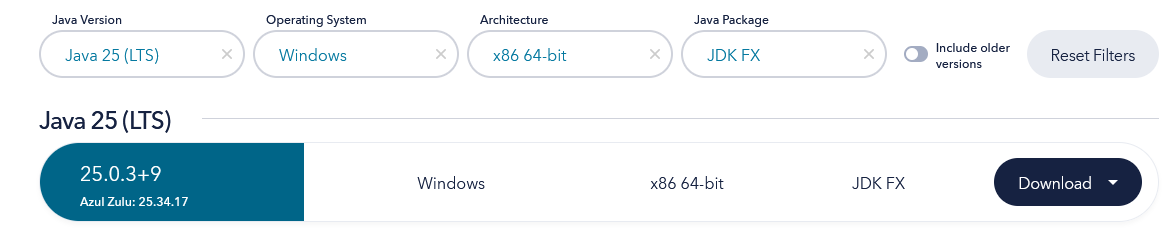
MSI Download verwenden.
Idealerweise vorher alle anderen, älteren Javainstallationen entfernen.
Jedenfalls Java Home setzen.
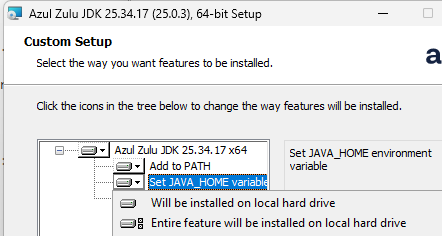
Update der ERP Datenbank
Durch die Reorganisation der ID und Belegnummern dauert das Datenbank-Update etwas länger.
Umstellung der Java Version in Jasper Studio
Da ab der Version 2.1 das Java 25 verwendet wird, solltest du auch die Java-Version des JasperStudio auf Java 21 umstellen. D.h. unter Window, Preferences, Java, Compiler
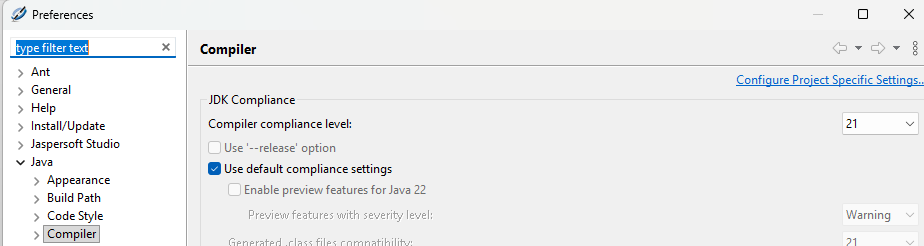
Da aber Java 25 verwendet wird, musst du das dem JasperStudio mitteilen. Dazu:
- Zusätzlich in ?:\Program Files\jaspersoftstudio\Jaspersoft Studio.ini
den Eintrag unter vm von features/jre.win32.win32.x86_64.feature_17.0.8.1_1/eclipsetemurin_jre/bin auf dein eigentliches Java Home stellen, sodass dies z.B. wie folgt aussieht:
-vm
c:\Program Files\Zulu\zulu-25\bin
- Nun auch noch im Java Build Path unter Libraries das verwendete Java 25 eintragen.
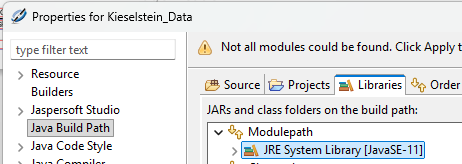
D.h. zuerst das eingerichtete Java 11 entfernen (Remove Library) und danach den Modulpath anklicken und mit Add Library
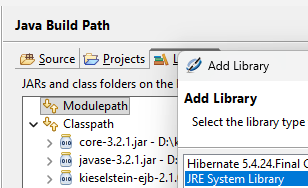
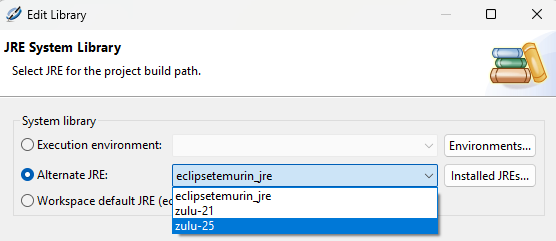
das auf deinem Rechner bereits installierte Java25 auswählen.
Denke daran, dass danach das JasperStudio neu gestartet werden muss.
Denke auch daran, dass du in diesem Zusammenhang auch das aktuelle Client EJB einrichten musst.
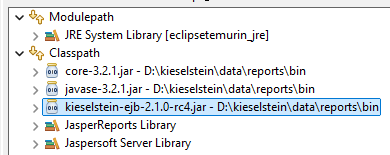
Da in der Version 2.1.0 auch die gemeinsamen Programmfunktionen von Server und Client vereinheitlicht wurden, muss zusätzlich auch das kieselstein-common
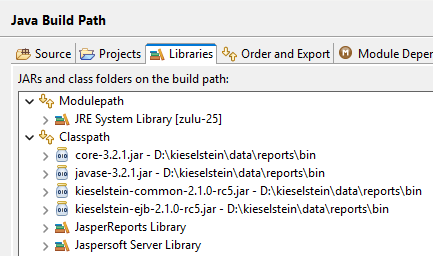
hinzugefügt werden muss.
Tools
Ab der Version 2.1 steht unter LW:\kieselstein\data auch das Verzeichnis tools zur Verfügung. Dieses funktioniert ähnlich dem LW:kieselstein\dist\clients ist aber für die Ablage von Dateien die Anwenderspezifisch sind gedacht, wie z.B. die passende Java-Version, die gewünschte Terminalversion, das APK für die mobile App und ähnlichem. Du findest dies dann unter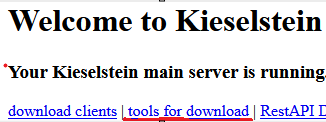
unter http://KIESELSTEIN_ERP_IP_ADDRESS:8080/
Migration der Dokumentendatenbank
Für die Migration der Dokumentendatenbank steht ein Script zur Verfügung.
Dieses muss passend zu deiner Ausgangssituation konfiguriert werden.
Diese findest du unter LW:\kieselstein\dist\bootstrap\jackrabbitmigration\migrate-jackrabbit.conf
In der Regel wirst du den INPUT_TYPE auf db stellen müssen.
Bei der Gelegenheit kannst du auch sehr einfach von der Ablage der Dokumente direkt in der Datenbank auf die Fileorientierte Datenbank für die Dokumente wechseln. Siehe dazu auch Umstellung auf fileorientierte Dokumenten Datenbank beachte bitte die Voraussetzungen
Dass du vor alle diesen Arbeiten ein vollständiges Backup deines Kieselstein ERP angefertigt und geprüft hast, sollte selbstverständlich sein.
Ein gutes Backup des gesamten Systems ist jedenfalls sehr von Vorteil
Aktualisieren deines Kieselstein ERP
Als Voraussetzung für die Migration, hebe zuerst die Kieselstein ERP Installation (das dist) auf die aktuelle Version 2.1.x. Hebe dann die KIESELSTEIN Datenbank (mit Liquibase usw.) und beginne erst danach mit der Migration der Dokumentendatenbank.
Also wie üblich das Liquibase Update ausführen.
Bei der Umstellung entfällt der programmierte PK Generator aller Tabellen und auch weite Teile des programmierten Belegnummern Generators (beide wurden durch Datenbankfunktionen / Wildflyfunktionen ersetzt). Darum werden beim Update auch die PKs der Belegnummern neu initialisiert, was etwas dauern kann (und auch ein Grund ist, warum es kein Zurück gibt).
Info
Prüfe zuerst ob die Ziel-Art der Dokumentendatenbank überhaupt startet.Info
Die Mirgration der Dokumentendatenbank muss nur einmal durchgeführt werden.Vorgehensweise bei DB zu DB, einmalig
Wie ist bei der einmaligen Migration von der alten Jackrabbit auf die Apache Jackrabbit Oak vorzugehen. Hier wird davon ausgegangen, dass die Daten für die Dokumente in beiden Fällen in der Datenbank abgelegt sind.
Für die Ergänzung einer bestehenden OAK-Dokumenten-Datenbank ist eine etwas geänderte Vorgehensweise erforderlich. Hier wird nur die einmalige Umstellung beschrieben.
Hier wird davon ausgegangen, dass die Migration im Verzeichnis LW:\kieselstein\migrate-jackrabbit\ erfolgt. D.h. auch, dass sich das migrate-jackrabbit Programm hier befindet.
Benötigter Platz: Es muss mindestens der doppelte Platz der Größe der Dokumentendatenbank noch frei sein. Gefühlt: unter 200GB freien Platz würde ich nicht anfangen.
- Den Kieselstein ERP Server (Wildfly) stoppen.
- Eine eventuell bestehende Datenbank KIESELSTEIN_DOCUMENTS_OAK löschen.
- Die Dokumentendatenbank (KIESELSTEIN_DOCUMENTS) hält die aktuellen Dokumente
- Das ev. bestehende Verzeichnis Data (aus dem Migrate) löschen
- migrate-jackrabbit.conf anpassen, sodass INPUT_TYPE=db und OUTPUT_TYPE=db auf db (Datenbank) gesetzt sind
- starte nun eine CMD-Shell mit administrativen Rechten und starte migrate-jackrabbit.bat
- dieser Lauf kann einige Stunden dauern. So hat die Migration von ca. 90GB Dokumentendatenbank auf einem schneller Rechner ca. fünf Stunden gedauert. Für diese Zeit steht dein Kieselstein ERP nicht zur Verfügung.
- Nach erfolgreichem Durchlauf, d.h. es gibt im Protokoll nur Infos und ev. Warnings, steht die konvertierte Dokumentendatenbank unter KIESELSTEIN_DOCUMENTS_OAK zur Verfügung.
- Benenne nun die KIESELSTEIN_DOCUMENTS_OAK auf KIESELSTEIN_DOCUMENTS um.
- Davon ausgehend, dass dein sonstiges Kieselstein ERP bereits auf dem aktuellen Stand ist, kannst du nun deinen Server starten.
- Prüfe stichprobenartig, ob alle Dokumente vorhanden sind.
Natürlich machst du dies zuerst auf einem Testsystem. Ja das kostet Resourcen, aber du weißt damit was du wirklich Platz brauchst, du kennst die Schritte und vor allem weißt du wie lange das dauern wird.
Info: Ev. wirst du für die Tests des Echtsystem auch einige Zeit brauchen. Hier hat sich bewährt, dass man, mit Ausnahme der an Tests beteiligten Benutzer allen anderen den Zugang sperrt. Bei einer entsprechenden Anzahl an Benutzer kann / sollte man das über die Datenbank machen.
Denke daran, das am Ende der Tests auch wieder freizuschalten.
Wenn du die Mirgration z.B. Testweise auf einem anderen Rechner durchführst, so denke, je nach Größe der Dokumentendatenbank, daran, die Energiespar / Abschaltoptionen zu deaktivieren. Es kann echt einige Zeit in Anspruch nehmen.
Vorgehensweise bei DB zu FS, einmalig
Wenn du dein Kieselstein ERP schon einige Zeit im Einsatz hast, bzw. wenn davon auszugehen ist, dass du eine große Menge an Dokumentendaten ablegen willst, so kann es, gerade aus Backup-Gründen von großem Vorteil sein, wenn die eigentlichen Dokumente im Filesystem abgelegt sind. Nutze diese Chance um von der Datenbankorientierten Dokumentendatenbank auf die Fileorientierte Dokumentendatenbank zu wechseln.
Hier wird davon ausgegangen, dass die Migration im Verzeichnis LW:\kieselstein\migrate-jackrabbit\ erfolgt. D.h. auch, dass sich das migrate-jackrabbit Programm hier befindet.
Benötigter Platz: Es muss mindestens der doppelte Platz der Größe der Dokumentendatenbank noch frei sein. Gefühlt: unter 200GB freien Platz würde ich nicht anfangen.
- Vorbereitung:
Stelle den Zugriff bereits auf die fileorientierte Dokumentendatenbank um.
Idealerweise setzt du dafür die Environment Variable
DOC_CONFIG
LW:\kieselstein\dist\conf\jackrabbit-datastore-fs.xml
- ff.) Achte peinlich darauf, hier auf genau diese Datei zu verweisen.
Starte nun dein Kieselstein ERP.
Du wirst zwar keine (bestehenden) Dokumente sehen, aber der Zugriff auf die Dokumentendatenbank muss gegeben sein. Hintergrund ist, dass damit die Konfiguration (workspace, datastore) entsprechend eingerichtet wird. Prüfe dies indem du z.B. eine Anfrage, eine Rechnung in die große Druckvorschau druckst. Es darf hier zu keinen Fehlermeldungen wie, Dokumentendatenbank ist offline und ähnlichem kommen. - Nun den Kieselstein ERP Server (Wildfly) stoppen.
- Eine eventuell bestehende Datenbank KIESELSTEIN_DOCUMENTS_OAK löschen.
- Die Dokumentendatenbank (KIESELSTEIN_DOCUMENTS) hält die aktuellen Dokumente
- Das ev. bestehende Verzeichnis Data (aus dem Migrate) löschen
- migrate-jackrabbit.conf anpassen, sodass INPUT_TYPE=db auf db (Datenbank) und OUTPUT_TYPE=fs auf fs (Filesystem) gesetzt sind.
- starte nun eine CMD-Shell mit administrativen Rechten und starte migrate-jackrabbit.bat
- dieser Lauf kann einige Stunden dauern. So hat die Migration von ca. 90GB Dokumentendatenbank auf einem schneller Rechner ca. drei Stunden gedauert. Für diese Zeit steht dein Kieselstein ERP nicht zur Verfügung.
- Nach erfolgreichem Durchlauf, d.h. es gibt im Protokoll nur Infos und ev. Warnings, stehen die KIESELSTEIN_DOCUMENTS_OAK und das Verzeichnis output/oak zur Verfügung
- Verschiebe nun den Inhalt von LW:\kieselstein\migrate-jackrabbit\output\oak\ nach LW:\kieselstein\data\jackrabbit\datastore (das vorher leer sein muss)
- Benenne nun die bisherige KIESELSTEIN_DOCUMENTS auf KIESELSTEIN_DOCUMENTS_OLD um und
benenne die KIESELSTEIN_DOCUMENTS_OAK als KIESELSTEIN_DOCUMENTS. Idealerweise trägst du in den Kommentar der jeweiligen Datenbank ein, woher diese Daten kommen - Davon ausgehend, dass dein sonstiges Kieselstein ERP bereits auf dem aktuellen Stand ist, kannst du nun deinen Server starten.
- Prüfe stichprobenartig, ob alle Dokumente vorhanden sind.
Denke daran, dein Backup entsprechend zu erweitern, sodass das Verzeichnis LW:\kieselstein\data\jackrabbit ebenfalls mitgesichert wird.
Infos
Im Migrationslog (= Bildschirmausgabe) stehen manchmal auch Einträge ähnlich
06.08.2026 07:15:53.759 [main] *INFO*
org.apache.jackrabbit.core.query.lucene.DocNumberCache - size=9/1024,
#accesses=1001, #hits=982, #misses=19, cacheRatio=99%
Das bedeutet nur, dass in diesem Falle 19 (=misses) Einträge nicht im internen Chache des Index nicht gefunden wurden. Im Endeffekt sagt dies, je mehr Treffer (hits), desto schneller ist die Migration. Ist also ein rein statistischer Wert.
Ganz am Ende der Migration kommt eine Zusammenfassung:
D.h. da steht dann z.B.
“Success: Datastores match”
oder bei fehlenden Einträgen je eine Zeile mit
“Missing node [id] at [path]”
Und am Ende
“Found [numErrors] errors during datastore validation”
Wichtig dabei: es wird nur geprüft, ob das neue Repository alle Daten des alten Repository korrekt übernommen hat. Wenn Dokumente im alten Repository bereits gefehlt haben, wird das nicht erkannt.
Vorgehensweise bei DB zu FS, auf V2.1.x
Umstellung mit bereits migrierter KIESELSTEIN_DOCUMENTS von der Basis alle Daten in der Datenbank auf nur mehr Metadaten in der Datenbank und die eigentlichen Blobs im Filesystem.
Hier wird davon ausgegangen, dass die Migration im Verzeichnis LW:\kieselstein\migrate-jackrabbit\ erfolgt. D.h. auch, dass sich das migrate-jackrabbit Programm hier befindet.
- Stoppen des Kieselstein ERP Servers (Wildfly)
- Eine eventuell bestehende Datenbank KIESELSTEIN_DOCUMENTS_OAK löschen.
- Die Dokumentendatenbank (KIESELSTEIN_DOCUMENTS) hält die aktuellen Dokumente
- Aus dem Verzeichnis gegebenenfalls das data und das output Verzeichnis entfernen
- migrate-jackrabbit.conf anpassen, sodass INPUT_TYPE=db auf db (Datenbank) und OUTPUT_TYPE=fs auf fs (Filesystem) gesetzt sind.
- starte nun eine CMD-Shell mit administrativen Rechten und starte migrate-jackrabbit.bat
Für die nachträgliche Migration einer bereits in der OAK Version vorliegenden Dokumentendatenbank auf die fileorientierte Version siehe ( /docs/installation/81_fileorientierte_dokumente_datenbank/#migration-mit-bestehender-oak-datenbank )
Verhalten bei falschen Java-Versionen
Was passiert bei der (meist versehentlichen) Verwendung falscher Java Versionen.
Wir gehen hier von der Version 2.1 aus, die sowohl am Server als auch am Client Java 25 verlangt
- Server mit Java 25, Client mit Java 21
Der Client startet nicht. Nutzt man nur das Desktop-Icon geht dieses kurz auf, es wird sehr kurz der Splash-Screen angezeigt und schließt sich wieder. Zum Prüfen ob das der Grund ist, starte den Client aus einer Command-Shell und prüfe die Java Version und das Java_Home - Server läuft unter Java 21
Server startet, scheinbar normal. Die internen Meldungen mit falscher Java Major Version überliest man sehr leicht, bzw. wenn als Dienst gestartet, muss man schon sehr genau suchen gehen.
Startet man nun den Client, der richtiger Weise unter Java25 läuft, kommt der Server ist nicht erreichbar.
Bei der nachfolgenden Meldung sieht man, dass der Server unter Java21 startet, es aber der wildfly-40/41 ist, also die Version 2.1.x des Kieselstein ERP, die Java 25 verlangt.
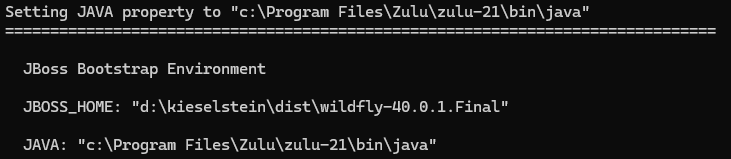
- startet man nun auch den Client mit Java 21, so verhält sich bereits der Client so, wie oben beschrieben.
Erster Start der OAK Documenten DB
Beim ersten Start der Dokumenten Datenbank wird gegebenenfalls ein Index nachgetragen. D.h. bei entsprechend großen Dokumentendatenbanken kann dieser erste Start etwas länger dauern. Siehe dazu gerne auch
Reindexing will be performed for following indexes
im system.log
Ab wann kann die Version 2.1 eingesetzt werden?
Wir arbeiten intensiv an der Fertigstellung der Umstellung. Die zwischendurch erstellten Versionen werden vor allem für die Prüfungen verwendet.
Die Ergebnisse der Prüfungen werden im GitLab unter den folgenden Issues aufgeführt.
| Release Candidat | Link |
|---|---|
| RC 1 | #631 |
| RC 2 | #636 |
| RC 3 | #645 |
| RC 4 | #647 |
| RC 5 | #648 |
| RC 6 | #657 |
Wir freuen uns sehr, wenn du uns bei der Prüfung der Funktionalität unterstützt. Es ist dies doch eine sehr große Umstellung.
Bitte beachte, dass für einen Produktiveinsatz diese Version freigegeben werden muss. Diese Freigabe sollte sowohl von Seite der Softwareentwicklung als auch durch deine umfangreichen Tests erfolgen.
Bitte beachte, dass wir leider keine Verantwortung für die Funktionalität übernehmen können. Um einen gute Qualität im Einsatz erreichen zu können, so wie bisher, sind wir auf die Prüfung durch alle Kieselstein ERP Verwender angewiesen.
Testen
Für die Durchführung der Tests sei auf das unter Umstellung auf die Version 2.0.0 geschriebene verwiesen. Tests
WICHTIG
Bitte die Tests nur in einer Testumgebung prüfen. Die derzeit vorhandenen Version der 2.1 unter Java 25 sind nicht für den Produktiveinsatz gedacht.Eine große Bitte
Solltest du einen Fehler feststellen, so ist das ärgerlich. Bitte notiere diesen Fehler, setze aber unbedingt deine Prüfungen fort, soweit irgend möglich. Wir wollen damit erreichen, dass mit einer einmaligen Änderung dann die gute Version zur Verfügung steht.
Bevor du uns den Fehler mitteilst, solltest du bitte im Git prüfen, ob dieser Fehler schon bekannt ist. Für die verschiedenen Release-Kandidaten wurden diese unter den oben angeführten Links gesammelt.
Reportänderungen
Solltest du in einem deiner Anwenderreports auf ww_artikel.n_umrechnugsfaktor zugreifen, dies wird nun aber der Version 2.1, RC4 mit n_umrechnungsfaktor geschrieben.
Verhalten bei anderen Schriften in Verbindung mit PDF
Ab der Version 2.0 wird standardmäßig die Arimo (z.B. wegen Zugferd etc.) verwendet. Werden nun in den Texteingaben, z.B. Kurzbrief, andere Schriften (wie im Report definiert) verwendet, so wird diese andere Schrift zwar in der Druckvorschau angezeigt. Beim Speichern der PDF-Datei wird dann leider anstelle der gewünschten Schrift wieder Arimo verwendet. Dies ist leider dem Jasper-Reports geschuldet und kann derzeit nicht geändert werden. Wir hoffen, dass mit dem JasperReport 7 dies verbessert wird.
Client-Icon, einfacheres Windows-Client-Install
Ab der Version 2.1 lautet der Name des Client-Icons (für Windows) Kieselstein_client.ico.
Zusätzlich solltest du, für die Client-Rechner die nur auf das Echtsystem zugreifen, die kieselstein_server_setzen.bat passend zu deiner Umgebung definieren und auf jedem Client-Rechner einmal als Administrator ausführen.
Danach kannst du bei jedem Update das Kieselstein_Windows_Client_install.bat ausführen.
Voraussetzung dafür ist, dass es im LW:\kieselstein\dist\clients\ eine passende client.zip Datei gibt (mit bin und lib aus der LW:\kieselstein\dist\clients\kieselstein-client-2.1.xx.tar.gz). Damit kannst du mit einem Browser von http://KIESELSTEIN_ERP_IP:8080/clients/Kieselstein_Windows_Client_install.bat aufrufen, womit diese Datei heruntergeladen wird und mit einem Doppelklick aus dem Download-Verzeichnis ausgeführt werden kann.
Optimierungen
DB Zugriffe
Wurde für Hybernate 7 in Verbindung mit Wildfly 41 entsprechend optimiert um so vorhandene Mehrgleisigkeiten zu vermeiden.
Speicherverwaltung
Mit der Version 2.1 haben wir auch die optimierte Speicher Verwaltung der JavaVirtualMachine verwendet. Laut Tests des JVM Teams sollte dies eine Speicheroptimierung von ca. 20% bringen und zugleich die Zugriffs-Geschwindigkeit auf die Java Objekte erhöhen.
Damit verbunden ist auch eine Optimierung des Garbage-Collectors, was wiederum dazu führt, dass, bei gleicher CPU Last, mehr Speicher für die JVM zur Verfügung gestellt werden kann.
Weiters wurde die Speicherverwendung der einzelnen Module optimiert. So sollte sich als einer der Effekte zeigen, dass bei der von vielen Menschen verwendeten Arbeitsweise (Modul auf, zu, wieder das gleiche Modul auf) der Speicherverbrauch konstant bleibt und somit schon daraus die Geschwindigkeit im Laufe des Tages entsprechend hoch bleibt.
Zugriffsgeschwindigkeit zwischen Client und Server
Ab dem RC 5 wurde die Anzeige des Dokumentes eines Datensatzes (Artikel, Rechnung) in einen eigenen Thread ausgelagert. Das bringt vor allem Geschwindigkeitsvorteile im täglichen Arbeiten, vor allem über VPN Tunnel. Es führt dazu, dass der Status, ob ein Dokument für einen Datensatz verfügbar ist, erst einige Millisekunden später tatsächlich aktuell ist. Der Vorteil ist, dass dadurch die eventuell vorhandene Wartezeit reduziert wird und man so effizienter mit der eigentlichen Aufgabe vorwärts kommt.
Notfallszenario
Was ist zu tun, wenn man, warum auch immer, von einer 2.1 RC4 (oder höher) auf die 2.0.0 oder niedriger zurück wechseln muss.
- ACHTUNG: Die Dokumentendatenbanken sind nicht kompatibel. D.h. du musst die alten Dokumentendatenbank einspielen und verlierst damit alle bisher neu erzeugten Dokumente
- in der Tabelle ww_artikel ist der n_umrechnungsfaktor wieder auf den Tippfehler n_umrechnugsfaktor zurückzuändern
- ein passendes Liquibase-Update ausführen